原论文首页 · 4K Image Super-Resolution on Mobile NPUs: Mobile AI 2026 Challenge Report
4K 端侧超分:INT8 模型的速度和量化损失
报告把输出尺寸、放大倍率、精度格式和芯片分别列出,适合作为端侧超分预算的起点。
文章信息与阅读大纲
4K Image Super-Resolution on Mobile NPUs: Mobile AI 2026 Challenge Report
arXiv 2611.00963v1 · 首次提交 2026-10-31 · 当周新稿
2026.11.06 周选第 4 篇 · 拍照 · 建议精读
阅读顺序:研究问题、核心方案、实验条件、业务验证。
研究问题与核心方案
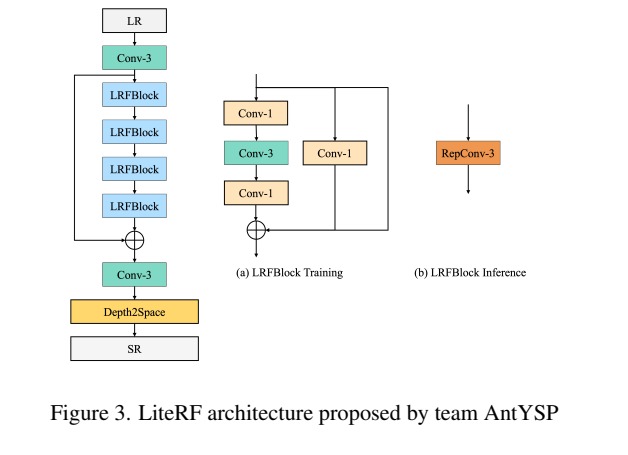
图 3 · 原论文第 5 页,点击查看原图
骁龙量化赛道的 LiteRF 以四个特征块工作。训练时用多分支卷积,部署时折叠为单个 3×3 卷积,利用残差传递高频,再将通道重排为空间输出。
实验结果与分析
表 1 的实际测速为 1280×720 到 3840×2160,三倍放大。AntYSP 在骁龙 NPU 上耗时 4.33 ms,PSNR 29.96 dB,较自身浮点网络损失 0.08 dB。天玑浮点赛道需单独比较。
表 2 中天玑浮点赛道 ZTE 的 PSNR 为 30.91 dB,NPU 耗时 110 ms。两赛道的精度格式、硬件及候选网络不同,不宜据此直接比较芯片性能。
研发判断与验证建议
精读依据 报告把输出尺寸、放大倍率、精度格式和芯片分别列出,适合作为端侧超分预算的起点。
用手机长焦的真实噪声与运动模糊替换 DIV2K 的理想退化;记录纹理误生成、量化条带和全链路耗时。